奥特曼:PC上装内存太浪费 最好留给AI数据中心
“从全球资源配置的角度来看,让每个人把紧缺的 DRAM 囤在自己电脑里大部分时间闲置,是『相当糟糕』(quite terrible)的安排,内存应该集中到云端数据中心去。”
话都说到这份上了。
本周四在接受 YouTube 频道 Cheeky Pint 的采访时,OpenAI CEO 山姆・奥特曼(Sam Altman)全程喝着啤酒,气氛轻松地聊了聊 AI 大模型的本地推理,以及由此延伸出的家用电脑内存不足的问题,不经意间爆典了。
我们知道,目前全球 AI 浪潮引发的内存涨价,已经让 PC 和手机的价格暴涨了一圈,个人消费者早已难以承受。与此同时,各家内存大厂的产能扩张还要等一阵子。就在前沿 AI 公司吃下内存大头的同时,他们却已经开始讨论起个人电脑中的内存是否得到充分利用。
奥特曼提到一个假设,即人们能够在自己的电脑上运行本地人工智能,这些电脑可能是他们已经拥有的,也可能是因为 AI 大模型技术兴起,他们想要组装的。他认为这是一个糟糕的想法。
“从全球资源分配的角度来看,让每个人都把全球有限的 DRAM 内存闲置在自己的电脑里,而使用率只有 5%,这其实非常糟糕,”奥特曼说道。“如果你想在这种资源供应极其紧张的环境下工作,那么在云端就应该尽可能提高资源利用率。但不知为何,很多人的直觉却恰恰相反。”
如今,OpenAI 的主要业务基于在大规模数据中心运行的闭源模型,他为自家商业模式的辩护引发了 AI 社区的一片争论。
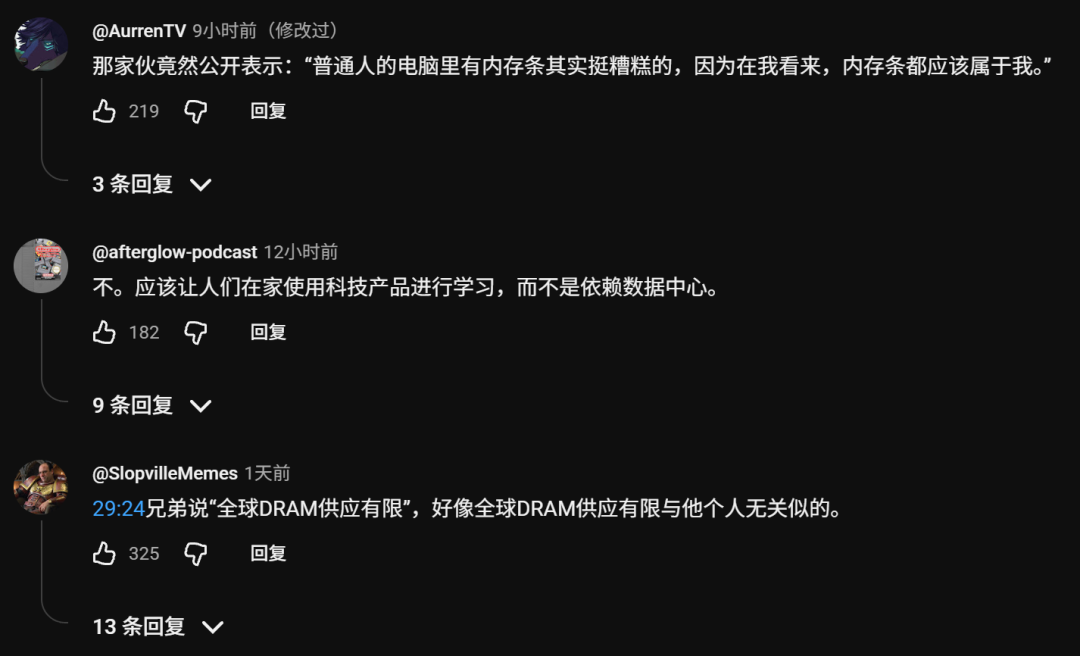
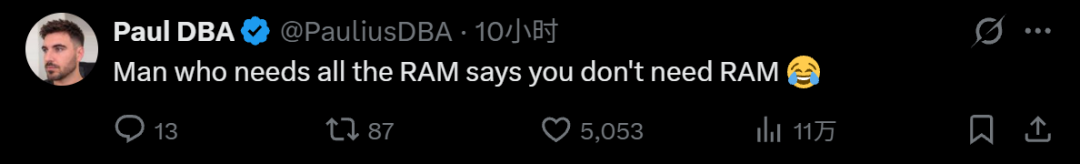
这也引发了不少人的担忧:未来我们可能更难拥有自己的硬件或软件,只能考虑去租用云端的智能体和计算机。
虽然普通 PC、手机和 AI 加速卡使用的内存并不相同,但它们的生产会竞争部分上游晶圆产能。奥特曼讨论的是全球 DRAM 的资源配置,要说到谁有资格决定内存产能用在哪里,大多数时候自然是下更大订单的那个用户。
奥特曼的部分观点基于数据中心建设不会放缓的假设。此外他还假设,全天候用于 AI 数据中心的内存比用于电子表格、网页浏览、游戏,甚至偶尔用于本地 AI 的内存更有价值。
其实这次的访谈很长,奥特曼聊的还包括这两周引爆全球恐慌的 PHP 漏洞、训练模型的沙箱化以及 AI 在数学领域的研究。
看看他主要说了些什么:
AI 正在引爆漏洞潮
有关 PHP 超级巨大的漏洞,奥特曼的判断是:大模型发现漏洞的能力持续快速提升,而互联网上的代码面极其庞大,当人们开始系统性地用 AI 扫描所有代码,“我们会发现自己身处一个严重漏洞远超预期的世界”。他认为光打补丁不够,必须重构架构,路由器、操作系统、应用层都需要为“漏洞会越来越智能”的世界重新设计。两年前“重写整个技术栈”还像疯话,现在已出现要做全新 stack 的创业公司。
他罕见地做了行业自我批评:“我不认为我们很好地向人们解释了,为什么这项技术所有潜在的下行风险是值得的。”他说 AI 行业的叙事是糟糕的销售话术,一边承诺治愈癌症、降低成本,一边又描绘失业、失控、需要强力监管的未来。他重申 OpenAI 坚持迭代部署(iterative deployment)、对抗能力悬置(capability overhang),理由是不能让“旧金山几平方英里的人做所有决定”。
当被问及能否给模型建一个“最高安全级别的监狱”,奥特曼给出了悲观回答:沙箱只在一定程度内有效,监控(包括思维链审查和激活监控)能再进一步,但最终必须高度信任对齐。他反问道,面对一个比最聪明的安全研究员还聪明百万倍、能发现人类尚不懂的新科学的模型,你真敢信任那个沙箱吗?
他明确说自己讨厌“agent swarms(蜂群)”这个词,因为 swarm 让人联想到蝗虫,坚持叫 agent teams(智能体团队),并认为团队之间互相制衡的属性,恰好对应靠多元主义实现鲁棒性的机制,是值得推进的安全方向。
智力爆炸与科学发现的代价
奥特曼勾勒了一条曲线:GPT-4 时代,往单个问题上有效投入 1 美元算力都难;思维链(chain of thought)让模型能“用力思考”,如今我们却可以把整支智能体团队并行上万次。普通用户和最先进用户之间的使用差距,正在不断拉大。
关于 OpenAI 内部如何分配算力,他说员工享有很大自由度,但从不奖励高 token 消耗,“token 排行榜高其实有点丢人,肯定不是晋升理由”。纳维 - 斯托克斯(Navier-Stokes)方程的证明被他拿来当案例:单个证明约耗资 1000 万美元,期间“失控了一周”,因为当时大家对智能体团队的扩展律一无所知。但他预计一年后用更聪明的模型和方法,1/100 的成本就能重做。
他还罕见地流露了情绪:当时的情况真是绝了,某个新模型内部上线的周末,大家把各种最棘手的难题抛给这个模型,而它竟然都能一一解决。人们原本根本没指望模型能做到这些。大家共同见证了许多人学术生涯中最难攻克的科研难题被这个模型一个接一个地解决了,而且涵盖了多个不同的领域,那场面简直令人惊叹。
“有两晚我几乎彻夜未眠,因为实在太兴奋了,根本睡不着。我们后来发表的很多成果,其实就是当时解决的那些难题。”
奥特曼当时感到无比兴奋和快乐,同时也涌现出一种意想不到的忧伤、惆怅,以及一种“某个时代正在终结”的感觉。不止是怀旧,还有一种对于对人类科学家们“朝闻道,夕死可矣”的共情。他坚持人类理应获得基础知识,但行业欠这些领域的从业者一个解决方案。
虽然现在谈论超级智能还为时尚早,不过奥特曼认为万亿个小超人类,胜过一个万亿 IQ:
"I would much rather intuitively have a trillion AIs of slightly superhuman intelligence join society than one AI of one trillion IQ join society."
“直觉上,我更愿意让一万亿个略具超人类智能的 AI 加入社会,而不是一个万亿 IQ 的 AI 加入社会。”
他的论证是:社会的强大鲁棒性来自大量成员互相制衡、协作,“单脑”世界没有这种韧性。但他强调这不会自动发生,必须主动推动。
市场调节,到 AI 时代玩不转了?
有关全球内存紧缺的问题,奥特曼介绍了 OpenAI 的布局:自研芯片(提升每瓦智能性能)、自建数据中心、机器人项目,以及一个更大胆的概念“自我复制的数据中心”,要用 AI 控制机器人去运营晶圆厂、造涡轮和太阳能板、建数据中心。他表示“这已在我们掌握之中”。
谈到“市场自己调节”为何迟迟不兑现,他认为当前的进展很糟糕,并给出内存厂商的行为逻辑:这个行业长期是投 200 亿美元 capex 赚 19 亿的苦生意,历史上多次有巨头因过度建厂而差点破产。如今每家一年能赚约 1000 亿美元自由现金流,但惨痛记忆让他们扩产极度保守。他由此断言“看不见的手现在失灵了”。
他区分了芯片产业的两类能力:光刻“地球上似乎只有一家公司知道怎么做”,但芯片设计(最终送给晶圆厂的文件)已是 AI 的绝佳用武之地。
谈到递归自我改进(RSI)的真实水平,奥特曼表示,现在模型能完成“找 5% 计算效率提升”这类任务,但还没有人知道如何让 AI 发现像 transformer 那样级别的新架构,缺的是更聪明的模型。他甚至预告,社会可能需要在一段时间内同意限制单模型的智商,“若未来的进展不足,那将源于这个决定,而非 AI 做研究的能力”。
他亮出了自己的通缩信仰:当前每 GW 领先 AI 算力的 5 年总拥有成本约 700 亿美元,若能降到 200 亿会更理想,同时模型每年还要再提升 10 倍性能。实现的路径是让能源更便宜、压缩“从沙子到产出 token”之间层层堆叠的毛利。
针对企业的 token 预算焦虑,他认为当前更普遍的问题是 AI 用得不够多,而不是用太多。
个人智能体怎么定价?
关于最近火热的个人智能体产品(如 Muse),奥特曼当前的判断是“Macintosh 时刻还没有到来”。人们喜欢这些产品,但还没到“无法想象没有它的生活”,赢家的形态会像现在的产品,但“it'll just work”,可靠、能接住更复杂的任务。computer use 的猫鼠游戏,他认为最终会收敛在“你有权让 AI 代表你操作自己的电脑”的程度。
有关智能体的商业化方式,奥特曼认为,企业死守自己产品里的 AI 弹窗和 HTML,担心失去客户关系,但消费者想在自己的主聊天应用里面让 AI 代办一切。他认为真正的护城河来自品牌、选品和履约网络,而非 HTML。他主动自曝说:自己 10 次有 10 次选 Amazon Pay,哪怕价格更高,并盛赞亚马逊的履约网络,同时承认 ChatGPT 内的合作平台做得还不够好。他还把所有网页表单称为“假工作”(fake work),并把当下类比为当年的 App Store 时代。
也正是因为如此,在设计定价时,OpenAI 差点学 AWS 按任务报价、彻底抛弃 token 计费的方式,但遭到了客户们的强烈反对:“我需要知道自己在为什么付钱”,哪怕付更多也要 token 这种可理解的单位。