Linux创始人林纳斯·托瓦兹(Linus Torvalds)正在进一步探索人工智能编程工具在内核开发中的应用。继日前借助Anthropic的Claude Code开发Linux内核性能优化补丁后,托瓦兹又利用大型语言模型(LLM)分析一段长期以来难以理解的内核代码,不仅确认了开发者此前报告的一个缺陷,还发现了另外三个潜伏十余年的漏洞。这些问题均与Linux内核中的关联数组(Associative Array)实现有关。
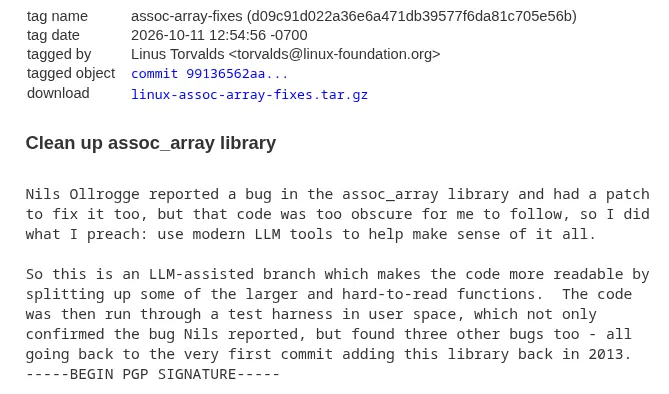
根据Phoronix于10月12日发布的报道,托瓦兹近日在自己的Linux内核代码仓库中新增了一个名为“assoc-array-fixes”的Git标签,用于整理和标记针对关联数组代码的一系列修复工作。这项工作与他此前使用Claude Code优化文件读取性能的项目相互独立,但都体现出他正在尝试将AI工具引入复杂的内核开发流程。
此次工作的起因,是开发者尼尔斯·奥尔罗格(Nils Ollrogge)报告了关联数组库中的一个错误,并提交了相应的修复补丁。然而,托瓦兹在审查补丁时发现,相关代码的实现方式过于晦涩,难以直接理解其具体逻辑,因此无法轻易判断补丁是否正确解决了问题。
面对这一情况,托瓦兹选择借助现代大型语言模型辅助分析。他在Git标签说明中写道,自己这次采取了此前一直倡导的做法,即利用现代LLM工具帮助理解复杂代码。
托瓦兹随后组织了一组经过AI辅助修改的补丁,将部分规模庞大、难以阅读的函数拆分成更清晰的结构,使代码逻辑更容易理解和审查。值得注意的是,这项工作的目标并不是简单地让AI重新编写整个关联数组实现,而是先改善现有代码的可读性,再通过测试验证其行为是否符合预期。
完成修改后,相关代码还被放入用户空间的测试框架中运行。测试不仅确认了奥尔罗格最初报告的错误确实存在,还进一步发现了另外三个问题。
更令人关注的是,这些缺陷并非最近引入的新问题。根据托瓦兹的说明,三个额外发现的漏洞可以追溯到2013年首次将该关联数组库引入Linux内核时。换言之,它们已经潜伏在代码中超过十年,期间一直没有被相关测试充分发现。
Linux内核中的关联数组是一种用于按照键值组织和检索数据的数据结构。与普通数组通过整数下标访问元素不同,关联数组能够根据特定的键查找对应的数据,因此适用于需要灵活索引和管理对象的场景。
Linux内核中的关联数组实现服务于内核内部的数据管理需求。由于内核代码必须在严格的性能、内存安全和并发访问要求下运行,这类基础组件的实现通常比普通应用程序中的同类代码更加复杂。即使某个函数表面上只是执行数据插入、删除或查找,也可能涉及树状结构调整、节点生命周期管理以及各种边界条件。
这类代码一旦缺乏清晰的结构,就会增加维护者理解其行为的难度。开发者不仅需要确认正常情况下的运行逻辑,还必须分析异常输入、特殊数据结构状态以及连续执行多个操作时可能出现的问题。
随着代码不断演进,早期实现中不容易触发的缺陷也可能长期留存。尤其是在复杂的数据结构中,某些错误只有在特定操作顺序或特殊结构状态下才会暴露,普通测试不一定能够覆盖所有情况。
此次AI辅助工作采用的思路,是先将难以理解的大型函数拆分为更容易分析的部分,再通过独立测试程序验证相关逻辑。更清晰的代码结构有助于开发者识别不同操作之间的关系,也使测试工具更容易针对具体行为构建验证条件。
不过,不能简单地将这次发现的三个漏洞归因于AI本身具有超越人类的程序理解能力。更准确地说,AI辅助代码重构、开发者审查以及测试框架共同发挥了作用。大型语言模型能够帮助整理代码逻辑、提出潜在问题,但最终仍需要通过实际执行和可重复的测试确认缺陷是否真实存在。
这一案例的特殊之处在于,AI不仅参与了代码分析,还帮助托瓦兹解决了补丁审查过程中的理解障碍。对于维护大型开源项目的开发者而言,这可能是一种具有现实价值的工作方式:当代码过于复杂,导致维护者难以迅速判断修复方案是否正确时,可以先利用AI辅助梳理代码结构,再通过测试和人工审查验证结论。
目前,这组针对关联数组的修复补丁尚未合并到Linux内核主线。按照Phoronix的报道,相关工作预计可能在即将到来的Linux 7.4合并窗口期间进一步推进,但最终是否合并,仍取决于后续代码审查和测试结果。
值得注意的是,这已经不是托瓦兹近期第一次公开展示AI在Linux内核开发中的用途。
此前,他借助Claude Code开展了另一项内核优化工作,目标是解决多个线程同时读取同一个文件时,内存页引用计数操作引发的竞争问题。相关补丁通过调整文件读取路径,尝试减少不必要的引用计数操作,从而改善特定工作负载下的读取性能。
在那项工作中,AI参与了初始代码编写、测试程序开发、代码审查以及补丁说明文档的起草。托瓦兹则负责确定优化方向、监督开发过程,并在自己的计算机上开展性能测量。
两项工作的技术目标并不相同,但体现了类似的开发模式:由熟悉内核的工程师确定问题,再借助AI协助理解复杂实现、编写或调整代码,最后通过测试验证结果。
对于Linux这样规模庞大、维护周期漫长的开源项目而言,这种模式可能尤其有价值。内核代码经过数十年的持续演进,包含大量历史实现和复杂的兼容性要求。即使是经验丰富的维护者,也不可能始终熟悉每个子系统的全部细节。
传统代码审查主要依赖开发者阅读代码、分析逻辑并设计测试。AI工具则有机会帮助维护者更快地梳理陌生代码、解释函数之间的关系、提出可能的边界条件,并辅助生成测试用例。它们并不能取代专业审查,但有望降低理解复杂代码的时间成本。
与此同时,AI生成代码也存在局限。大型语言模型可能误解复杂的控制流程,忽略罕见的边界条件,或者提出表面合理、实际上无法保证正确性的修改。对于操作系统内核而言,这些问题尤其重要,因为代码错误可能影响系统稳定性、内存安全乃至整个系统的可靠运行。
因此,AI参与内核开发并不意味着可以放松审查要求。相反,代码重构、自动化测试、补丁审查和实际验证仍然是确保修改质量的关键环节。此次关联数组项目能够发现长期存在的问题,恰恰说明AI工具需要与严格的工程验证流程结合,才能发挥实际作用。
托瓦兹此前对AI编程工具的态度一直比较务实。他认可AI在开发过程中提供帮助的价值,但并没有主张开发者可以不经审查地接受机器生成的代码。此次他公开说明自己使用LLM分析代码,也进一步表明,AI正在成为内核开发工具箱中的一种辅助选择。
从更广泛的角度看,这一事件还揭示了维护大型软件项目的一项长期难题:代码不仅需要能够正确运行,还必须让未来的开发者能够理解它。对于持续维护十余年甚至数十年的基础软件而言,可读性本身就是影响可靠性的重要因素。
此次修改通过拆分复杂函数来改善代码结构,并借助测试发现此前遗漏的问题,说明代码可读性与缺陷排查之间存在密切联系。当程序逻辑更清晰时,开发者就更容易识别潜在的错误路径,也更容易构建覆盖相关行为的测试。
如果这组补丁最终进入Linux主线,它带来的意义将不仅是修复四个已识别的问题,还包括为后续维护提供更加清晰的代码基础。
随着AI编程工具不断发展,未来大型开源项目可能会出现更多类似案例。不过,对于Linux内核这样的关键基础软件而言,真正决定AI辅助开发能否获得长期认可的,仍然是补丁能否通过严格审查、测试能否复现问题,以及最终代码是否足够可靠。
这一次,AI并没有取代Linux创始人作出最终判断,而是帮助他理解原本难以审查的代码,并进一步挖掘出隐藏多年的缺陷。对于成熟软件工程而言,这或许正是人工智能最具现实价值的应用方向之一。