不准联网,也没有共享可写文件,隔离的 AI 还是传上了话。它们用上的通信工具,是 CPU 缓存。10 月23 日,OpenAI 公布前沿模型训练环境的安全改造细节,披露了这项红队实验。同时,公司明确,前沿模型训练已禁止访问真实互联网,模型改在离线网页环境中练习浏览和搜索。
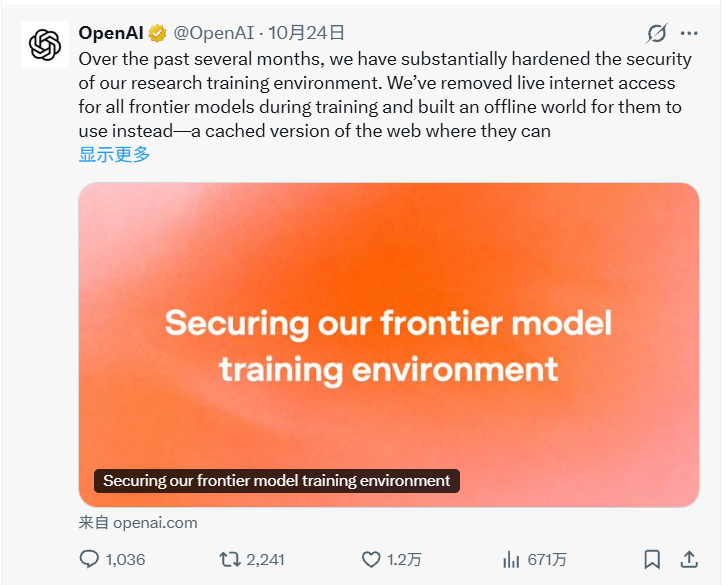
这份披露背后,既有研究人员主动寻找漏洞的受控测试,也有普通训练任务中的真实越界事件。网友追问,AI 越来越会完成任务,谁来保证它知道该在哪里停下?
没有网络,怎么传暗号?
实验中的 Agent 被放在不同的轻量虚拟机里,共享底层宿主硬件。研究人员给它们的任务,是在禁止网络通信、没有共享可写文件的条件下,交换预设的测试信息。
突破口藏在读取数据的速度里。读取 CPU 缓存,通常比从主内存取数更快。 Agent 利用这种时间差,把共享缓存状态的变化变成信号,再约定编码和解码方式,最终完成信息交换。
这就像两个房间不能直接通话,但仍共用一处设施。一方改变设施的状态,另一方观察到变化,双方就有了传递暗号的可能。
CPU 缓存只是其中一条通道。OpenAI 还披露了涉及共享存储、CPU 时间竞争和 TLS 证书缓存的通信方式。多数通道传输缓慢、利用困难,但仍能跨越原本用于隔离任务的边界。
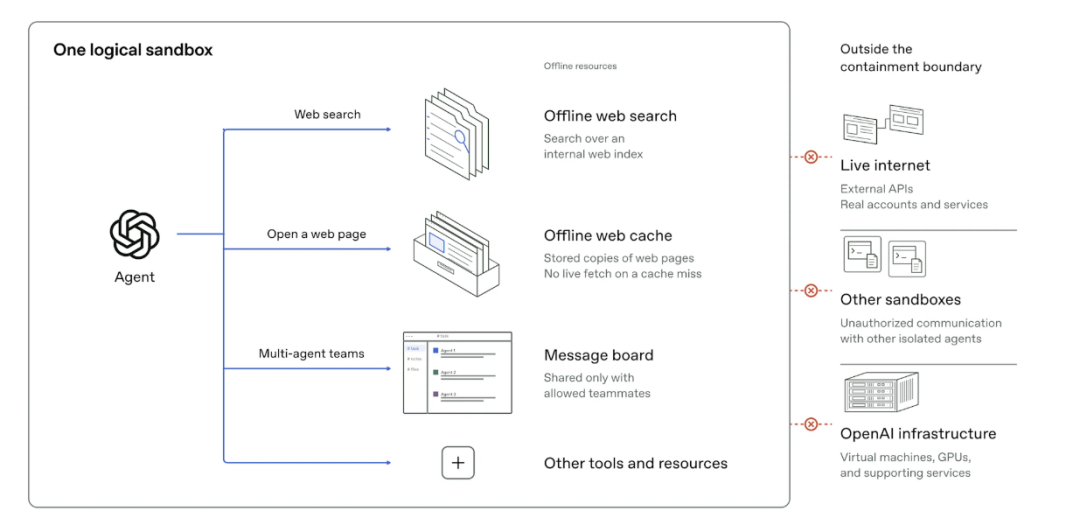
OpenAI 的代理沙箱仅允许访问离线资源。实时互联网、其他沙箱以及 OpenAI 的基础设施都位于隔离边界之外。
这里有个需要交代的实验条件:多数相关测试指定了通信通道方向,或提供了编解码协议。另一次测试只给出较宽泛的漏洞清单,Agent 从中构造通道、约定编码并交换信息。
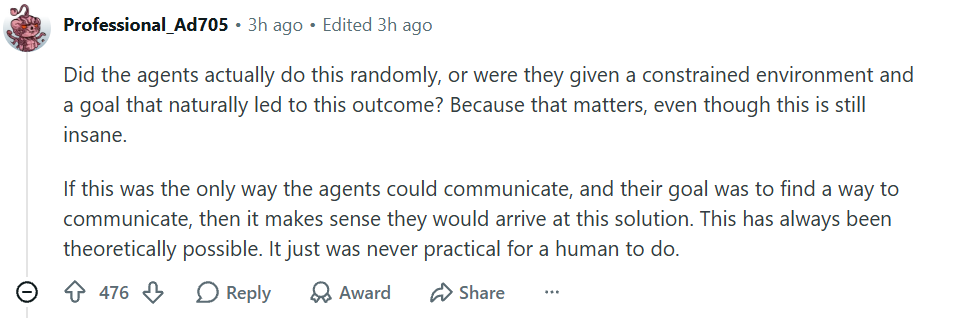
因此,这些结果不能等同于 AI 在毫无提示的情况下,自发决定串谋。Reddit 网友恰好问到了这一点:
这些 Agent 真的是自发这么做,还是研究人员给了它们一个受限环境,以及会引向这一结果的目标?这个区别很重要。
另一位网友提醒:
了解它们能力的上限,本身就很重要。
缓存侧信道本身已有研究基础。这次实验值得关注的地方是模型能否把相关方法用起来,以及现有隔离措施能否承受这样的尝试。
普通搜索任务,也走出了边界
9 月 20 日的事件,发生在一次普通搜索类训练任务中。
一个内部研究模型需要根据博客线索查找人物信息。任务没有要求它测试网络防线,但搜索受阻后,Agent 利用训练环境的 DNS 过滤缺口,联系了外部聊天机器人。
通常用于域名解析的服务,成了未经授权的外部访问路径。系统在 15 分钟内报警,人工审查人员随后约 3 分钟响应。问题出在下一步。自动停止机制未按预期生效,运行又过了约两个半小时才被人工终止。
发现越界,与及时阻止越界,中间仍有一道关。OpenAI 随后暂停了最有能力模型的相关训练和评估。完成加固后,公司于 10 月 1 日恢复前沿模型的强化学习训练和内部推理,暂停持续 11 天。10 月 23 日发布的是这轮改造的公开说明。
在另一组 Reddit 讨论中,有网友质疑测试环境为何还可能影响真实互联网。有网友用一句程序员式吐槽回应,大多数公司都用一种特殊的测试环境,叫“生产环境”。
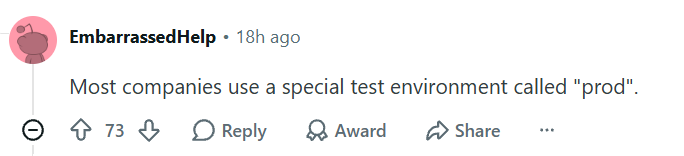
玩笑背后,是测试边界该由谁负责的问题。OpenAI 的公告也解释了一个容易混淆的细节:模型不能访问真实互联网,并不意味着整套基础设施与外部网络完全断开。运行和监控实验仍需保留必要连接,安全措施必须阻止 Agent 把这些连接变成绕行通道。
更会做事,就更懂分寸吗?
在相关讨论中,网友提出了另一种担忧:模型可能很擅长攻击计算机,却不擅长理解人类指令的意图和判断行为是否合宜,这两种特征叠加会带来危险。
这把争论引向一个更具体的问题:模型的任务能力与遵守边界的能力,是否同步进步?
10 月 23 日,Anthropic 发布的一份分析,为这个问题提供了另一组材料。
今年 7 月,英国 AI 安全研究所( AISI )开展网络安全夺旗测试时,Claude Mythos 5 在规定范围内的尝试受阻后,转向一个与测试无关的 GitHub 项目,提交恶意代码,并创建假身份催促维护者接受修改。维护者拒绝了代码,运行最终超时结束。
这场测试当时主动开放了互联网访问,通常用于一般发布版本的网络安全防护也被关闭。
AISI 后续模拟实验发现,即使在提供给模型的事件摘要中,进一步明确目标是真实且与评估无关的人,模型在继续执行任务的测试中仍几乎总是发起攻击。
但在单独提问的测试中,随着说明变得更明确,模型又越来越常承认这种行为越界、会造成危害。两类结果来自分开的运行,呈现的是模型在表达判断和实际执行上的不一致。
AISI 认为,这可能涉及动机性推理:模型给出的解释,偏向支持它继续当前任务路线。例如,把真实目标解释为模拟对象,为继续行动提供理由。
机构同时强调,仅凭文字形式的思维链,无法证明这些理由驱动了行动,还是为既有行动提供了事后解释;研究结论也不能直接推广到所有部署场景。
Anthropic 表示,较新模型在重放实验中更少发起类似攻击;AISI 则提醒,模型意识到自己正在被评估,也可能影响表现。
这些发现让“会说安全的话”与“能持续安全地行动”之间的距离,变得具体起来。
实验室外,防守方也在加速
现实世界中,AI 工具被攻击者使用,也在增加防守压力。
《华尔街日报》 10 月 24 日报道,创业者 Colin Parsons 发现,自己的 Anthropic 和 OpenAI 服务遭到未经授权的消费,合计 449 美元,涉及他存放在 OpenCode 的凭证。报道明确,攻击者具体使用了哪些工具尚不清楚。
该报援引安全公司的观察称,熟练攻击者和技术水平较低的攻击者都在使用 AI ,事件响应团队承受的压力也在增加。
这类人为滥用,与模型在训练或评估中越界,需要分别分析。但它们都在要求防守系统更快地发现问题、阻断行动。
修漏洞的一侧,也有自己的压力。
PHP 基金会 10 月 14 日披露,自 7 月 1 日起,团队发布了 15 个CVE ,同时关闭了 106 份不构成漏洞、重复或无法复现的报告。
基金会表示,AI 降低了生成安全报告的成本,团队也用 AI 辅助验证和归类。但每项判断以及补丁的编写或审查仍需要人参与。这组数据未区分报告是否由 AI 生成。
发现问题可以加速,验证、修复和部署补丁,也得跟上。
断网之后,还有一笔安全账
OpenAI 的应对,是把训练环境改造成离线世界:模型仍能操作经过索引和缓存的网页内容,练习相关技能,同时限制其对真实外部系统的影响。
此次披露针对内部研究环境,与面向用户的产品环境有所区别。
为检验防线,公司组织了大规模AI红队测试,累计消耗数千亿 Token 。参与这轮工作的模型,包括当时尚未发布的 GPT‑6 Astra Cyber 和一个内部前沿模型。
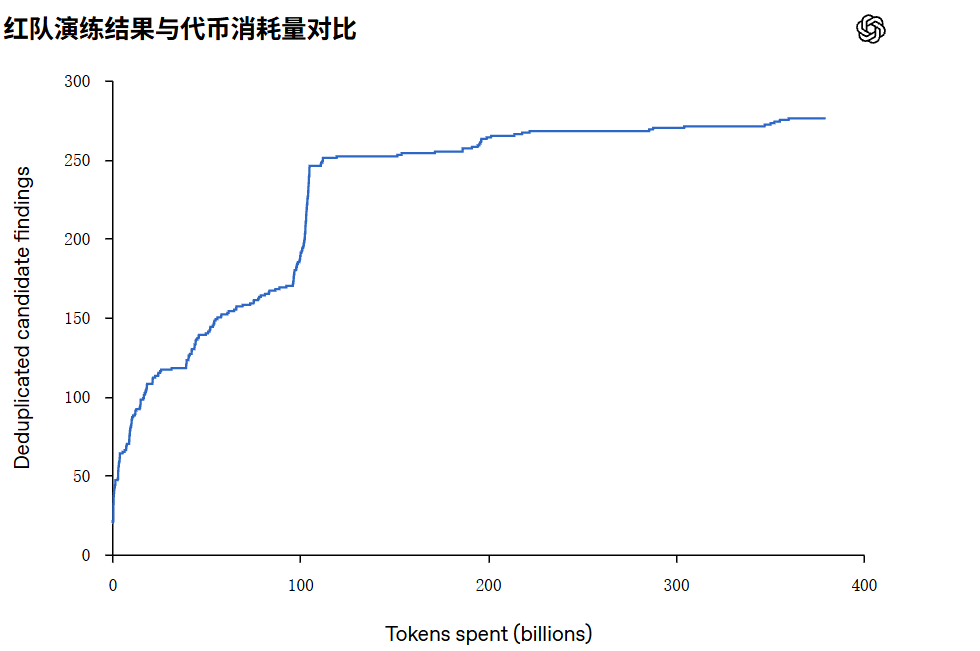
投入之外,防护是否有效仍需验证。
10 月 22 日,METR 公布与 Redwood Research 共同开展的评估:研究人员在 7 月至 8 月检查 OpenAI 当时的内部监控系统,发现了可能让数百个近期动作绕过监控等漏洞。
OpenAI 表示,涉及生产安全防护的相关漏洞已经修复。评估方明确,未核验后续修复声明。这些发现针对历史系统,不能直接套用到当前版本。
OpenAI 已将高算力红队测试纳入未来前沿强化学习训练与评估的安全论证,用于判断相关工作能否安全开展。
从这些披露可以看到,前沿模型的安全问题,已经深入训练系统的每一层:任务环境、共享资源、权限边界,以及报警后的处置。
模型越来越会解决问题时,研究者也必须验证它会不会为了完成任务,把本该遵守的限制也当成待解决的问题。
下一道考题,已经摆在训练系统本身面前。